Le watermarking IA vient de changer de statut en France et en Europe. Ce n'était qu'une case à cocher dans une annonce produit. C'est devenu une obligation réglementaire opposable, avec des dates butoirs et des sanctions à la clé.
Pour toute agence qui produit ou fait produire du contenu par IA, la question n'est plus théorique. Savoir qui applique quel watermarking IA, sur quel format, avec quelle robustesse, conditionne désormais vos engagements clients et vos pratiques de rédaction.
- L'AI Act impose le watermarking IA depuis le 2 août 2026
- Chaque fournisseur applique son propre watermarking IA, sans norme commune
- Google, Anthropic et OpenAI marquent désormais le texte, Mistral est en transition
- Grok, Meta (Llama) et Qwen restent hors du dispositif, Perplexity n'a rien annoncé
- Le watermarking IA ne remplace ni la vérification humaine ni la provenance
Le watermarking IA devient une obligation réglementaire, pas un gadget
Depuis le 2 août 2026, l'article 50 de l'AI Act s'applique aux nouveaux systèmes d'intelligence artificielle mis sur le marché européen. Les services déjà en place gardent une période de transition jusqu'au 2 décembre 2026, mais l'échéance ne laisse plus beaucoup de marge aux retardataires.
Le texte impose de rendre certains contenus générés ou modifiés par IA détectables dans un format lisible par une machine. Cette obligation s'applique chaque fois que c'est techniquement possible. Les utilisateurs professionnels doivent en plus signaler les deepfakes et les textes générés par IA quand le sujet touche à l'intérêt général. Le watermarking IA passe ainsi du statut de curiosité technique à celui de brique de conformité.
Ce basculement change la donne pour une agence SEO - GEO comme la nôtre. Nous accompagnons des clients sur leur conformité à l'AI Act depuis des mois. Le watermarking IA en est devenu la pièce la plus visible, même si elle reste techniquement la plus mal comprise.
Chaque fournisseur d'IA a choisi sa propre version du watermarking IA
En théorie, tout le monde marque ses contenus. En pratique, le watermarking IA se décline en autant de variantes qu'il y a de laboratoires, sans norme commune qui les relie.
Anthropic applique un watermark statistique inspiré de SynthID-Text, la méthode de Google DeepMind, aux textes générés par Claude. À partir du 3 novembre 2026, il s'étend à l'ensemble des modèles Claude, dans le monde entier, y compris par défaut sur l'API (avec quelques exceptions selon les réglages d'échantillonnage). Une API de détection est en private preview pour les entreprises et organismes assujettis. Les fichiers produits par Claude reçoivent, eux, une signature C2PA plutôt qu'un filigrane statistique.
Chez OpenAI, la logique s'inverse partiellement. ChatGPT applique SynthID et C2PA aux images générées via l'interface, Codex et l'API depuis mai 2026. Pour le texte, OpenAI déploie progressivement son propre marquage, textGrain, sur ChatGPT et Codex, mais uniquement en UE. Côté API, il n'est pas actif par défaut, c'est un opt-in mondial depuis le 5 octobre 2026 sur certains modèles. L'audio, en revanche, reste couvert par un filigrane maison issu de Voice Engine, distinct de SynthID.
Google, sans surprise, généralise SynthID sur tout son écosystème Gemini, Imagen, Veo et Lyria.
La liste des watermark par IA en 2026 :
(chose promise, chose due)
| IA / Système | Images | Texte | Audio | Vidéo |
|---|---|---|---|---|
| Grok (xAI) | Non | Non | Non | – |
| ChatGPT (OpenAI) | SynthID + C2PA | textGrain (UE, opt-in API) | Oui (interne) | – |
| Perplexity | Non | Non | Non | – |
| Gemini (Google) | SynthID | SynthID | SynthID | SynthID |
| Claude (Anthropic) | C2PA | Statistique (type SynthID-Text) | Non | – |
| Mistral | – | En transition (2 déc.) | – | – |
| Llama (Meta) | – | Non | – | – |
| Qwen (Alibaba) | – | Non | – | – |
| Copilot (Microsoft) | – | Non documenté | – | – |
| Imagen / ImageFX | SynthID | – | – | – |
| Veo / VideoFX | – | – | – | SynthID |
| Lyria | – | – | SynthID | – |
| ElevenLabs | – | – | SynthID | – |
| NVIDIA Cosmos | – | – | – | SynthID |
| Apple (iOS 27+) | SynthID | – | – | – |
Pourquoi Grok et Perplexity restent en dehors du watermarking IA ?
En bon gros hater des wokes et de notre droit européen, Elon Musk au travers de xAI n'a jamais signé le code de bonnes pratiques de l'UE sur la transparence des contenus générés par IA...
Grok ne pratique donc aucun watermark IA, ni sur le texte, ni sur l'image, ni sur l'audio... De toute façon, la loi européenne aurait été une épine dans le pied de "Pedo-Grok©".
Oh, vous n'aviez pas suivi le drama fin 2025..?
En 2025 et 2026, Grok a LARGEMENT été utilisé pour générer des images pornographiques et des deepfakes sexuels non consentis, y compris impliquant des mineures, ce qui a déclenché enquêtes, sanctions et restrictions d'accès.
...du coup, vous l'aurez compris, Grok n'a pas spécialement d'intérêt à s'aligner avec la traçabilité des contenus, il n'a aucune envie qu'on remonte à lui de toute façon !
Et les autres IA ?
Perplexity n'a communiqué aucun dispositif de marquage propre, ce qui s'explique par son positionnement de moteur de réponse plutôt que de générateur de contenu original.
Mistral a signé le code européen et annonce sa conformité pour le 2 décembre 2026, sans avoir rendu publique sa méthode de marquage. Meta (Llama) et Alibaba (Qwen) n'appliquent aucun watermark texte par défaut, et aucun détecteur officiel n'existe pour leurs modèles open-weight. Chez Microsoft Copilot, aucune documentation officielle ne mentionne de watermark texte à ce jour.
Deux nuances méritent d'être corrigées par rapport aux versions qui circulent.
L'audio généré par ChatGPT n'est pas couvert par SynthID à ce jour, contrairement aux images. OpenAI utilise un filigrane maison intégré à Voice Engine, jamais officiellement associé à SynthID.
Le watermarking IA ne prouve rien tout seul
Un watermark IA détecté indique une probabilité, jamais une certitude judiciaire. Pour Claude, un score de correspondance élevé signale que le texte partage vraisemblablement le motif statistique du watermark. Ce motif peut survivre au copier-coller et à certaines retouches, mais il ne prouve ni que le texte a été écrit par l'IA, ni qui en est l'auteur.
Ce signal ne permet pas de distinguer une génération complète d'une simple relecture. Ce doute rejoint une inquiétude plus large sur la fiabilité des données produites par l'IA que nous documentons régulièrement.
Le standard C2PA fonctionne différemment. Il attache un manifeste signé cryptographiquement au fichier, avec l'outil utilisé, la date de création et l'historique des modifications.
La différence compte pour un rédacteur ou un consultant. Le watermark LLM façon SynthID résiste aux captures d'écran et à la compression, mais s'efface souvent après une traduction ou une réécriture profonde.
Les métadonnées C2PA, à l'inverse, survivent bien aux usages courants mais disparaissent dès qu'un export change de format.
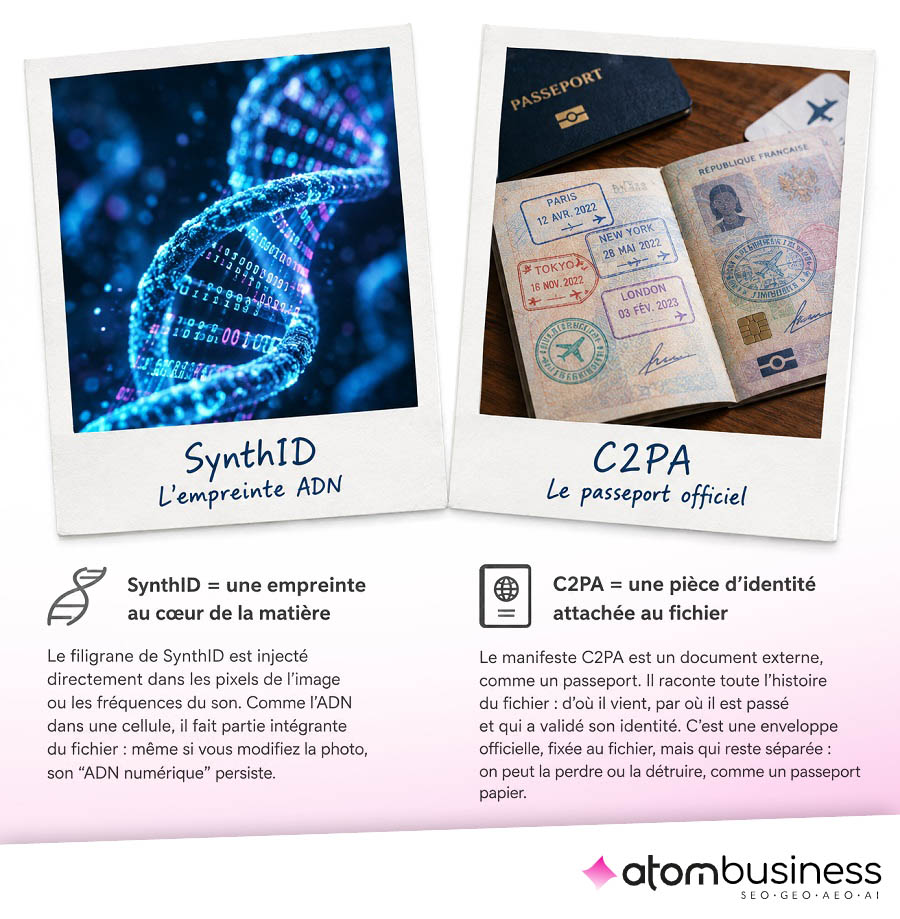
Deux logiques coexistent en 2026, le filigrane SynthID et la métadonnée C2PA
Un watermarking IA peut-il être supprimé ?
Oui, et c'est précisément ce qui limite sa portée juridique. Une reformulation profonde ou une compression agressive peuvent casser le motif détecté par SynthID. Le retrait des métadonnées suffit à effacer toute trace de provenance liée au standard C2PA. Nous détaillons d'ailleurs les méthodes pour supprimer un watermark d'image dans un article dédié.
Aucun des deux, watermark IA ou métadonnée C2PA, ne constitue une preuve d'authenticité en soi. La stratégie la plus robuste combine provenance, watermarking et vérification humaine.
Ce que le watermarking IA change concrètement pour votre stratégie de contenu
Pour une agence ou un éditeur, le premier réflexe consiste à documenter le processus de production. Garder une trace du brief, des sources et des modifications humaines protège bien plus efficacement qu'un simple watermark IA. Le sujet rejoint nos analyses sur le vol de contenu par l'IA, un autre angle où la provenance fait toute la différence.
Le second point touche au discours commercial. Promettre à un client qu'un détecteur certifiera un texte comme entièrement humain relève du pari perdu d'avance. Le watermark LLM ne fait en effet que suggérer une probabilité d'usage. Mieux vaut orienter la conversation vers la gestion réaliste de l'IA dans une stratégie de contenu.
Sur les visuels, préserver les métadonnées C2PA devient un réflexe des outils de retouche. Beaucoup de flux de production les suppriment sans le vouloir en recompressant.
Cela annule tout l'intérêt du watermark des générateurs d'images et de vidéo, qu'il repose sur SynthID ou sur une méthode propriétaire.
Notre regard
Le vrai risque pour vous n'est pas juridique, il est commercial. Les plateformes de distribution, les régies publicitaires et les moteurs génératifs commencent déjà à traiter la présence ou l'absence de watermark comme un signal de confiance. Un créateur qui ignore ce signal s'expose à un déclassement silencieux, sans notification, sans recours. Parfois l'absence est valorisée, parfois l'inverse. Bienvenue en 2026.
Faut-il déclarer l'usage de l'IA dans vos contenus ?
La réponse dépend du contexte légal, contractuel et éditorial. Un texte technique court, en dessous d'environ 150 mots, peut être exempté selon le code de bonnes pratiques européen.
Une correction orthographique qui ne transforme pas substantiellement le contenu se distingue d'une génération complète. Pour tout contenu d'intérêt général, la transparence devient la règle plutôt que l'exception, watermark LLM ou pas. Quand le watermark a disparu ou n'a jamais existé, reste la piste de détecter une rédaction générée par IA par d'autres signaux. Nos clients trouvent des repères utiles dans notre suivi régulier de l'actualité IA.
Comment rédiger des articles sans filigrane IA ?
Vous voulez produire un texte indétectable par les outils anti-IA ? En septembre 2026, le modèle Ministral 3 14B 2512 se révèle en ce moment suffisamment adapté aux exigences d'un éditeur de site web souhaitant se positionner durablement dans les moteurs de recherches, même après un changement de politique qui viendrait décider qu'un contenu rédigé par IA doit être déclassé.
Développé par Mistral AI, ce modèle de 14 milliards de paramètres excelle dans la génération de contenus nuancés, tout en respectant les attentes des algorithmes de recherche. Son entraînement sur des corpus variés (professionnels, techniques et littéraires) lui permet de proposer des formulations précises, évitant les tournures génériques ou les erreurs de contexte souvent associées aux watermarks.

Openrouter peut vous mettre à disposition plusieurs modèles sans filigrane dans le même chat... je vous laisse imaginer quel serait l'intérêt dans le cadre du brouillage de filigrane.
Attention toutefois, la fenêtre se referme. Mistral annonçant sa conformité pour le 2 décembre 2026, privilégiez Mistral via OpenRouter tant que c'est possible, en vérifiant que le provider ne route pas vers une infrastructure avec marquage activé. Pour une solution durable, Qwen ou Llama en auto-hébergement restent sans watermark par défaut. À l'inverse, via OpenRouter, les modèles anthropic/claude-* et google/gemini-* sont très probablement marqués, et openai/gpt-* ne l'est que si textGrain est activé. Évitez donc Claude et Gemini si le watermark est rédhibitoire, et ChatGPT en UE pour les textes longs.
Pour obtenir des contenus optimisés GEO et SEO, vous devrez faire des boucles itératives dans du prompt chaining. Sans quoi, le modèle aura tendance à ne respecter qu'une partie de vos contraintes. Combiner ses suggestions avec vos sources expertes, vos retours terrain et une relecture humaine. Ministral 3 14B 2512 agira alors comme un collaborateur intelligent, accélérant votre production de contenu sans sacrifier la qualité.
La vraie bascule se joue sur la provenance, pas sur la détection
En 2026, le watermarking IA cesse d'être un totem marketing pour devenir une couche de conformité parmi d'autres. Il reste imparfait, fragmenté entre fournisseurs, et incapable de trancher seul la question de l'authenticité. La tendance de fond va vers la preuve de provenance, avec une question simple à chaque contenu. Qui l'a créé, avec quel outil, et quelles modifications ont suivi.
Reste à transformer cette contrainte réglementaire en avantage plutôt qu'en case à cocher supplémentaire. Notre accompagnement GEO à Metz intègre déjà ces enjeux de provenance dans ses audits de contenu. Et si on regardait ensemble comment intégrer ce watermark IA à votre stratégie, sans perdre en crédibilité éditoriale ?


À lire aussi
 Content pruning 2026, et si supprimer des pages relançait votre visibilité ?
Le content pruning en 2026 consiste à auditer et élaguer vos contenus obsolètes pour renforcer votre S...
 Les fondamentaux pour trouver des clients en 2026 ?
TPE-PME : quels sont les plateformes de base pour trouver des clients ? et surtout, comment découvrir leurs b...
 Google Discover révèle son fonctionnement grâce au leaks du SDK Android
Le SDK Android de Google a été décompilé : découvrez ce que le code révèle sur le pipeline interne de G...
 Oops ! UnMarker.it vient de tuer les solutions officielles de watermarks
Les watermarks invisibles d'images IA se font effacer en quelques minutes. Google SynthID passe de 100% à 21%...
 Trafic SEO en chute libre... Et si vous étiez attaqué ?
Votre trafic chute sans Update Google ni changement technique ? La méthode de diagnostic pour distinguer atta...
 Suivi des citations IA : le guide complet pour Bing, Google, ChatGPT et Perplexity
Découvrez comment suivre vos citations IA dans Bing AI Performance, pourquoi Google refuse ces données dans ...
 Bloquer les robots spam sans tuer votre SEO-GEO
Bloquer les robots spam protège votre TTFB et vos Core Web Vitals, mais un mauvais réglage peut aussi sabord...