On le voit de plus en plus en 2026, jusqu'à 95% du trafic sur vos sites web vient de robots. Bienvenue en 2026, où bloquer les robots spam n'est plus une option de confort, c'est une question de survie pour votre TTFB, vos Core Web Vitals et votre référencement.
Le problème, c'est que tout le monde s'est mis à bloquer des bots de spam sans discernement. Un robots.txt bricolé un vendredi soir, une règle .htaccess copiée sur un forum, et le sysadmin croit avoir réglé le problème. Sauf qu'il a parfois bloqué Googlebot au passage. Avouez que ça calmerait n'importe qui.
- Les robots spam représentent jusqu'à 95% du trafic sur certains serveurs
- Ils dégradent le TTFB et les Core Web Vitals avant même qu'un visiteur humain arrive
- bloquer les robots spam sans distinction fait perdre du trafic SEO et GEO
- Un WAF Cloudflare bien réglé réduit la charge serveur de 40% en moyenne
- Robots.txt, .htaccess et WAF se combinent, aucun ne suffit seul
Pourquoi bloquer les robots spam est devenu vital en 2026
Ce n'est plus un fantasme de sysadmin parano. Cloudflare mesure les crawlers IA à 4,2% des requêtes HTML fin 2025, avec des pics à 6,4% mi-2026. GPTBot a bondi de 305% entre mai 2024 et mai 2025, et l'ensemble des bots grimpe à 30 voire 33% du trafic HTTP total. Face à ça, bloquer les robots spam devient un réflexe aussi basique que changer un mot de passe.
TollBit et Kinsta racontent la même histoire. Début 2025, une visite sur 200 était un bot IA. Fin 2025, c'est une sur 31. Un seul robot, ClaudeBot, a généré 3,75 millions de requêtes de type ajout au panier en 24 heures sur un site marchand.
Voilà pourquoi bloquer les crawlers est devenu un réflexe de survie, pas un luxe de grande entreprise. Ses Core Web Vitals ont mécaniquement dévissé le temps que quelqu'un s'en aperçoive.
Core Web Vitals, TTFB, le vrai coût technique des robots spam
Fastly a mesuré une progression du trafic IA environ 6,5 fois plus rapide que celle du trafic humain début 2026. Un seul fetcher a atteint 39 000 requêtes par minute sur un site, de quoi saturer les threads PHP et la base de données. Meta pèserait à lui seul 52% du trafic crawler IA, devant Google et OpenAI. Sans bloquer les robots spam responsables, votre TTFB grimpe et vos Core Web Vitals trinquent avant même qu'un humain ouvre la page.
Chaque requête non cachée occupe un thread, qui fait attendre la suivante. La file grossit, le TTFB explose, et vos Core Web Vitals plongent avant même votre premier visiteur humain de la journée. Une étude Springer 2026 confirme le phénomène. Bloquer robots spam sur 30 à 50% du volume technique suffit à diviser la charge par deux et à faire respirer le TTFB.
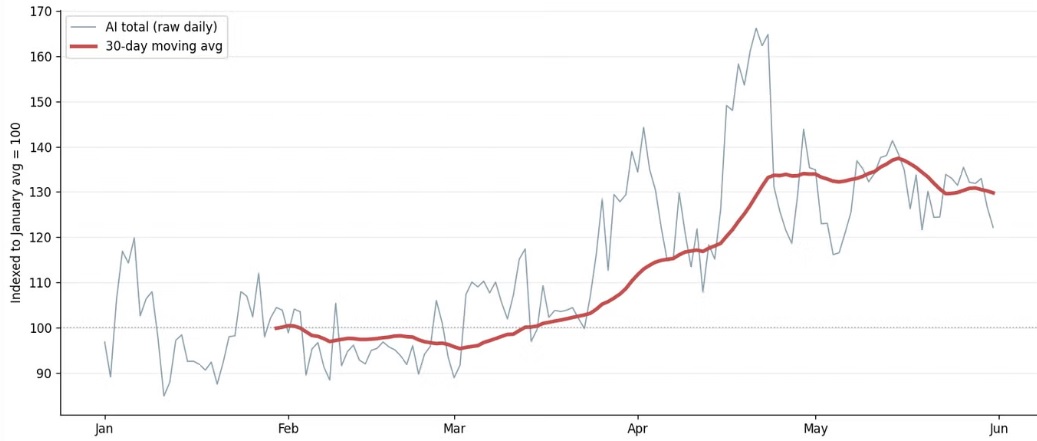
Les analyses de Fastly sont évocatrices face au spam des robots crawlers en 2026.
Qui paie vraiment la facture de ce trafic fantôme ?
C'est votre entreprise qui paiera la note. Sur votre TTFB en premier lieu. Wikimedia a vu sa bande passante multimédia grimper de 50%, alors que les bots ne représentent que 35% des pages vues mais 65% du trafic coûteux côté serveur. Read the Docs a payé plus de 5 000 dollars en un mois à cause d'un crawler ayant aspiré 73 téraoctets de HTML compressé, dont 10 en un seul jour.
Après avoir décidé de bloquer les robots spam responsables, leur trafic fichiers a chuté de 800 à 200 gigaoctets par jour, une économie d'environ 1 500 dollars par mois et des Core Web Vitals bien plus stables.
Le sujet rejoint des pratiques déjà documentées dans notre page sur le SEO black hat, où la frontière entre protection légitime et sabotage involontaire d'un TTFB fragile est tout aussi fine.
Bloquer robots spam sans détruire son SEO, la ligne de crête
Vous voulez bloquer les crawlers ia les plus agressifs, vous ouvrez votre robots.txt ou votre configuration Apache ou Nginx, et vous tapez une règle trop large.
Résultat, vous venez aussi de bloquer Googlebot, Bingbot, ou le SearchBot d'un moteur IA qui vous envoyait du trafic qualifié. Votre sécurité vient de se transformer en sabotage SEO et GEO, et vos Core Web Vitals n'y gagnent rien puisque le vrai volume venait d'ailleurs.
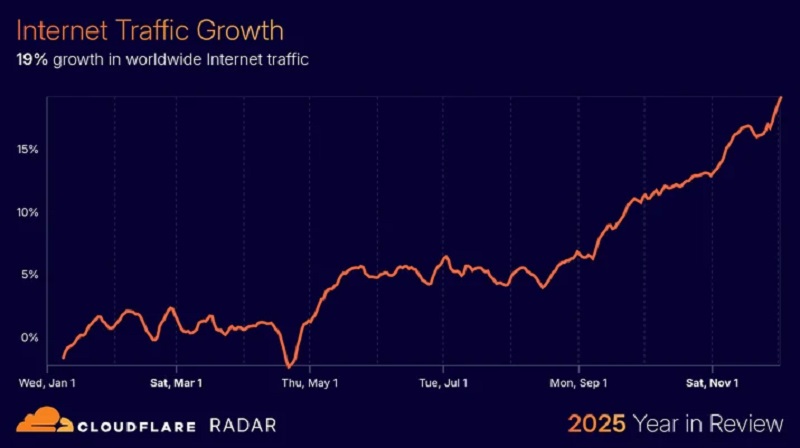
Tendances du trafic Internet sur l'année 2025 à l'échelle mondiale.
Les données le confirment. Les bots de search bien élevés, ceux de Google et de certains moteurs IA, sont généralement épargnés par les acteurs sérieux quand ils décident de bloquer des bots de spam. Les robots d'entraînement agressifs restent la cible principale. Environ 80% des grands sites d'actualité américains et britanniques bloquent aujourd'hui au moins un bot d'entraînement, sans toucher aux bots de recherche qui les font vivre.
C'est la nuance qui sépare un audit Core Web Vitals sérieux d'un bricolage qui tourne mal.
Faut-il bloquer tous les robots inconnus par principe de précaution ?
Non, et c'est justement là que la plupart des sites se plantent en voulant bloquer robots spam trop vite. Un robot inconnu n'est pas automatiquement hostile. Certains crawlers IA génèrent aujourd'hui du trafic de citation réel, un sujet détaillé dans notre analyse du système anti-scraping de Google. Bloquer à l'aveugle, c'est risquer de couper une source de visibilité GEO en pleine croissance pour gagner un TTFB à peine meilleur.
Les cas concrets qui prouvent qu'un blocage propre change tout
Balistas, un site e-commerce multilingue, a choisi de bloquer des robots spam via Cloudflare, plus de 600 000 requêtes par jour. Résultat, une charge serveur en baisse de 40% et des Core Web Vitals qui n'ont jamais aussi bien tenu, sans perte de visibilité de marque. Wikimedia, SourceHut, GNOME, KDE, Fedora et Diaspora ont tous connu des ralentissements liés à des scrapers IA mal filtrés.
You can see the impact of this even when the files are behind a CDN. Many of the files they are crawling are large and not frequently accessed, which causes a huge amount of traffic to origin servers, adding bandwidth and server costs. pic.twitter.com/Jo4YTz4URj
— Read the Docs (@readthedocs) July 30, 2024
Selon Clutch, 42% des PME interrogées ont signalé une tension bande passante ou performance liée aux bots sur douze mois, avec un TTFB dégradé à la clé.
Read the Docs a documenté tout l'épisode dans un billet détaillé sur l'abus des crawlers IA.
Notre astuce
Cloudflare propose AI Labyrinth ainsi que des règles fines pour bloquer les robots spam d'entraînement en un clic sans toucher aux bots de recherche. Beehiiv et Patreon ont renforcé leur contrôle en périphérie, faisant chuter les tentatives de crawl d'entraînement à quasi zéro tout en gardant les bots de recherche utiles.
N'attendez pas pour libérer vos serveurs de cette charge illégale !
Un WordPress mal configuré ou un serveur Apache et Nginx sans rate limiting rendent urgent le réflexe de bloquer robots spam avant que le TTFB ne s'effondre. Un WAF Cloudflare bien paramétré, couplé à un robots.txt propre et quelques lignes de .htaccess ciblées, règle 80% des cas.
Accidents courants
Les robots crawlers sur Internet évoluent, masquent illégalement leur user agent, contournent les règles trop statiques... Bloquer robots spam efficacement en 2026 demande une connaissance globale de l'écosystème et une veille. Ce n'est malheureusement pas magique comme le pense certains webmasters qui détruisent leur SEO-GEO en configurant les firewalls, qui bloquent le spam mais également les robots légitimes !
Les 20% restants demandent de savoir quel robot mérite de passer, sans sacrifier les Core Web Vitals que vous avez mis des mois à stabiliser.
Besoin d'être épaulés pendant cette action ?
C'est là que l'accompagnement change la donne pour bloquer les robots spam sans y laisser des plumes. Distinguer un robot spam d'un crawler qui alimente votre visibilité GEO, ou ajuster un accompagnement SEO sur mesure, ça se construit avec quelqu'un qui a déjà vu le film. Notre agence SEO à Metz traite ce diagnostic chaque semaine, avec un regard qui dépasse le copier coller de configuration.
Et si on regardait ensemble comment bloquer robots spam intelligemment, sans jamais couper une source de trafic SEO ou GEO qui vous fait vivre ?


À lire aussi
 Blocage des robots, l'erreur à éviter absolument
Le blocage de robots par absence de chargement des ressources repère les scrapers, mais peut aussi bannir Goo...
 Google Jules : l'agent IA qui code pendant que vous faites autre chose
Google Jules est l'agent IA de codage autonome de Google. Fonctionnement, différence avec ChatGPT, tarifs gra...
 Google abandonne la suppression des cookies tiers
Google renonce à supprimer les cookies tiers dans Chrome. Analyse des raisons, conséquences et perspectives ...
 ChatGPT, le secret qui explique pourquoi vous ne voyez pas le trafic qu'il vous envoie
Le SEO domine toujours le trafic web face à ChatGPT en 2026. On débunk les 3 excuses qui expliquent supposé...
 Selon l'Europe, ChatGPT est un moteur de recherche
ChatGPT est désormais classé moteur de recherche par l'Europe. Voici ce que ce statut DSA change pour votre ...
 GEO on-site : vraies techniques ou arnaque ?
L'optimisation GEO on-site est-elle une nouveauté inédite... ou juste une arnaque propulsée par LinkedIn ? ...
 Le SEO est-il mort en 2026 ? (Réponse : Bah non.)
Le SEO est-il vraiment mort en 2026 ? Bilan chiffré, données de marché et perspectives : spoiler, il s...